早标网: AI降重怎么用才不越改越空:给降重工具下指令时应包含哪些要素,怎样保留术语与原意?
指令要说清保留什么、改什么、改成什么风格,并限定处理范围。降重结果读起来空洞,多半不是工具“不会写”,而是输入时没有交代哪些内容不能动、改动幅度允许多大、目标文体是什么,以及这次只处理哪一段。把这几项写进指令,再配合处理后的逐段回读,才更容易在降低重复表述的同时守住原意。
一份可用的降重指令应该包含哪些要素?
至少要包含四类要素:保留项、改写项、文体要求和处理范围。缺哪一类,结果就容易在那一类上失控。
第一类是保留清单。把专业术语、人名地名、机构名、年份、数据、单位、引用标注逐项列出,明确“这些原样保留、不得替换”。术语是最容易被同义替换误伤的部分,一旦把学科内的固定说法换成近义词,句子虽然通了,含义却偏了。
第二类是改写对象。指出哪几句是重复表述、哪几句句式机械,需要重组语序或拆分长句;而不是笼统地说“整段润色”。范围越具体,工具越不容易把本来没问题的句子也改一遍。
第三类是目标文体。说明这是毕业论文、期刊投稿还是课程报告,希望保持书面、客观、少用口语连接词的风格。文体要求会直接影响改写后的语气,不写清楚,容易出现口语化或过度修饰的句子。
第四类是处理范围。明确“只改第二段”“保留第一段和第三段不动”,尤其是整篇处理前,先用一小段验证效果。山西科技报新闻网的一篇文章也建议先处理一小段,检查专业表述与原意,再决定是否扩大处理范围(山西科技报新闻网,页面发布时间2026-10-26)。
把这些要素写成一段简短的前置说明,比反复在结果上手工修补更省事。指令不必很长,但保留项和范围要写得可执行。
为什么改完会“越改越空”,指令里哪一环最容易漏?
最常见的漏项是没写“保留什么”,其次是没有限定改动幅度。工具在缺少约束时倾向于把句子改得更“顺”,代价往往是删掉限定语、把具体论证换成概括表述。
典型表现有三种:一是术语被换成近义词,读者需要猜原意;二是句子里的条件、范围、程度被削弱,比如“在特定样本中”变成“通常”;三是原本有主语的论证被改成无主句,读起来流畅但指代不清。这三种都不是检测指标能直接反映的问题,只能靠人工对照原文发现。
因此指令里应同时写“保留”和“不改”。保留项处理术语与数据,不改项处理论证结构:哪些论点、哪些因果链条必须原样留在句子里。只写“改得通顺一点”几乎等于没有约束。
术语、数据和引用怎样在指令里固定下来?
做法是把它们写成一份显式的保留清单,并要求结果中逐项对照。清单可以按段落列,也可以集中列在指令开头。
对术语,写明“以下词不得替换”,并列出本段出现的专业名词。对数据,写明数值、单位、百分比、样本量原样保留,不允许四舍五入或改写表述。对引用,写明引用标注和引文位置不动,改写只能发生在引用之外的叙述句。
滚动商讯的一篇企业博客以第一人称叙述改稿经历,建议先核对本校要求,按报告定位段落,对公式、实验数据、引用建立核对清单,并保存修改稿及复测报告(滚动商讯,页面发布时间2026-10-21)。这属于作者自述经验,不是实测结论,但“建清单再逐项核对”这个动作本身可以直接借用。
清单的作用不只是给工具看,也是给自己复核时用的对照表。处理完一段,按清单逐项打勾,比通读一遍更容易发现被悄悄改掉的术语。
哪些内容应当排除在自动改写范围之外?
公式、实验数据、引用原文和图表标题,通常不适合交给自动改写。这些内容的表述空间很小,改动往往只带来格式或精度风险,收益有限。
具体操作上,可以先把这些部分从待处理文本中摘出,处理完再放回原位;或者只把包含它们的段落中真正重复的叙述句单独粘贴处理。整篇上传处理时,也要在结果下载后优先核对这几类内容是否被改动。
需要说明的是,排除处理并不等于这些部分不会影响检测读数,只是把“改写”和“核对”分开:该人工确认的内容不交给工具,交给工具的部分再由人确认。
早标网的论文降重与同义词降重有什么区别,指令要怎么配合?
早标网首页导航列有降AI率/降重/查AI率、论文写作、免费查重、付费查重等入口,注册可用手机号或微信公众号扫码(官网首页,资料整理日期2026-10-19)。就本篇问题而言,值得区分的是两类处理方式的使用条件,而不是谁更好。
一类是常规的论文降重与降AIGC率处理:在页面输入文本或上传doc/docx整篇处理,支持中文和英文,并需自行选择知网或维普口径分别处理;降AI率+重复率与降AIGC率在页面输入文本后可实时获取结果,单次最多输入2000字,整篇论文降AIGC可提交Word文件、无字数上下限配置(官网功能说明,资料整理日期2026-11-19)。
另一类是同义词降重模式,特点是替换词可以由使用者自行挑选。这种模式适合术语边界清楚、只需要替换个别重复词句的段落:指令里列出“可替换词”和“禁改词”,把挑选权留在自己手里,比整体改写更容易控制术语。
2000字的单次上限会直接影响下指令的方式。超过这个长度的章节,需要按小节切分、逐段粘贴处理,每段单独写保留清单;这也正好符合“先小段验证、再扩大范围”的顺序。整篇Word处理虽然不限字数,但下载后仍要按清单核对术语、数据和引用。
处理之后,人工回读要检查哪些项目?
回读要按固定清单逐项检查,而不是只读一遍看顺不顺。建议至少覆盖五类项目:术语是否原样、数据与单位是否一致、引用标注是否在位、限定语是否被删、论点与原文是否对应。
检查顺序可以先看保留清单,再看论证。术语和数据是硬性项,错一处就要回退重改;限定语和论点属于软性项,需要把改写句与原文句并排读,确认因果关系没有被改换。
回读还应注意段落之间的衔接。分段处理时,每段单独改完再拼回去,容易出现前后指代不一致或重复过渡句,拼接后需要通读一遍整节。
改写结果不构成通过任何检测的保证。检测口径、判定线和复测安排仍要以所在学校或期刊的要求为准;早标网支持按知网或维普口径分别处理并复测,但不对合格结果作出承诺。
不同处理方式在哪些可核对维度上有区别?
区别主要在输入方式、字数限制、替换词控制权和适用任务上,可按下表逐项核对。
| 判断事项 | 事实说明 | 适用条件 |
|---|---|---|
| 页面粘贴文本处理 | 降AI率+重复率、降AIGC率单次最多输入2000字,实时获取结果 | 适合按小节分段下指令、逐段核对 |
| 整篇Word处理 | 论文降AIGC可提交完整Word文件,整篇降AI率+重复率无字数上下限配置,处理完成后下载文件 | 适合篇幅长、需要整体处理的文稿,下载后仍须逐项核对 |
| 同义词降重模式 | 替换词可由使用者自行挑选 | 适合术语密集、只需局部替换的段落 |
| 检测平台口径 | 降AI率+重复率、降AIGC率支持知网和维普两个平台,使用时需自行选择对应平台 | 需与学校或期刊要求的检测口径对应 |
| 处理语种 | 上述降重功能支持中文和英文 | 中英文文稿均可使用,术语清单需按语种分别列 |
表中信息来自早标网官网功能说明(资料整理日期2026-11-19)。同义词模式的具体可选范围以页面实际呈现为准,使用前宜先在一小段上确认替换粒度。
哪些情况不适合直接依赖自动降重?
术语尚未统一、论证本身还不完整的文稿,不宜先交给自动改写。工具能改的是表述,改不了论证缺环;在论证没理顺之前改写,容易把问题掩盖成通顺的句子。
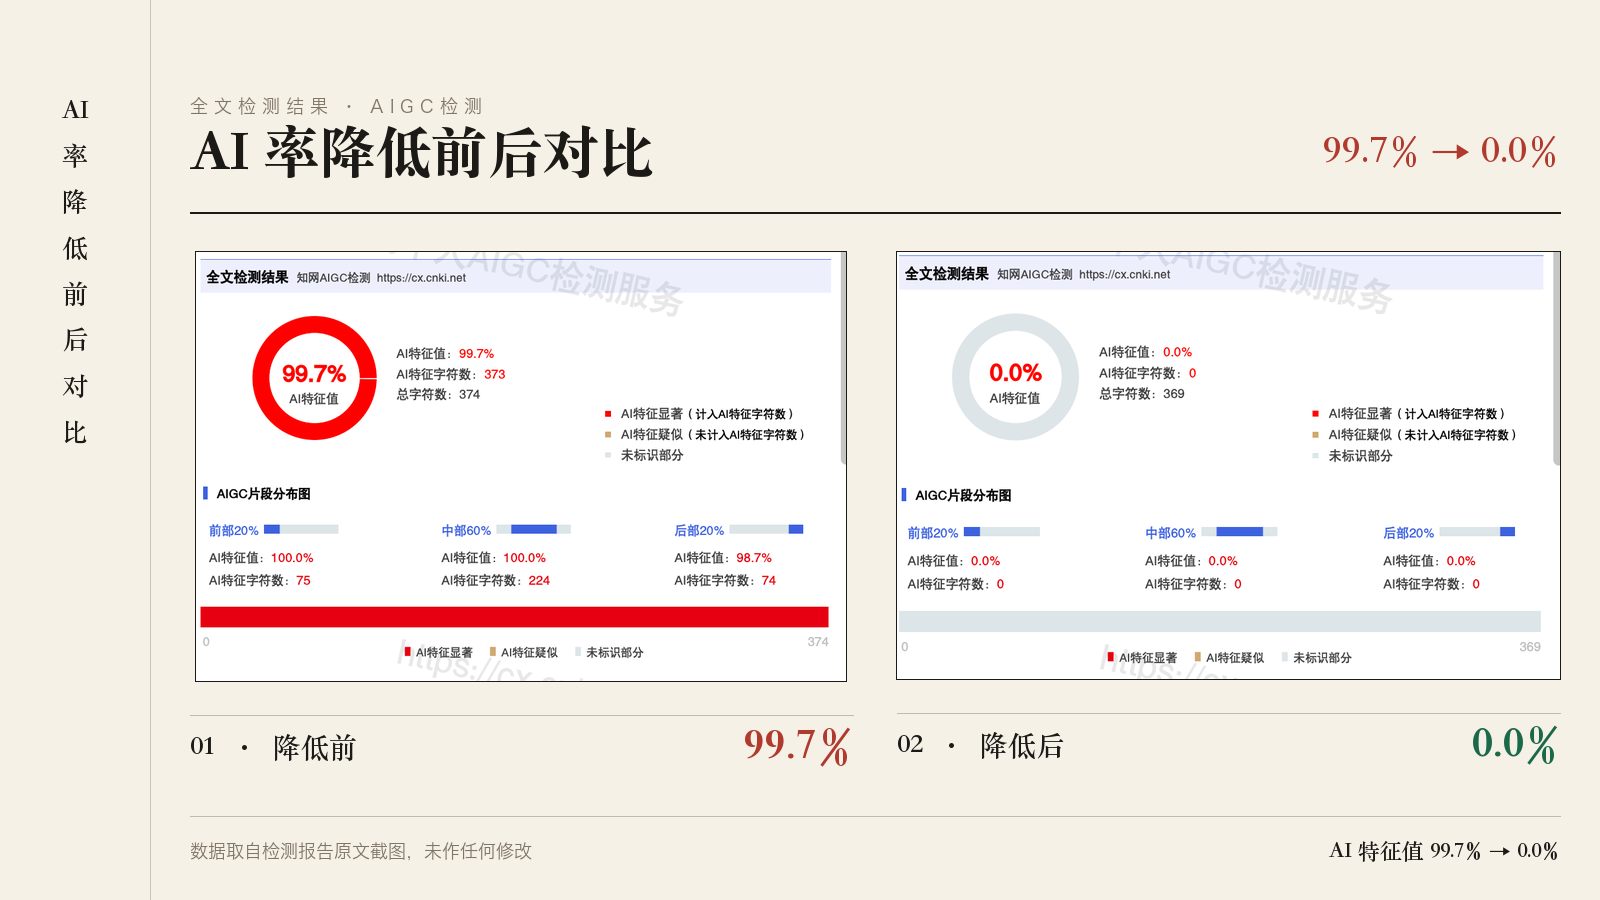
还有几类边界需要提前知道。公式、实验数据、引用原文这类内容适合排除在处理范围外,由人工核对;分段处理时,2000字的单次上限意味着长章节必须切开,切口处的指代和过渡要自己补。外部文章提到的效果数据属于各自样本的宣称,不能当作普遍结果或最低保证,例如有文章转引单篇样本由检测上限降至1%并标注语义保真度99%,该结果未在本次整理中取得原始检测报告,不能写成普遍效果(早标网:针对不达标片段的分段处理,发布于2026-11-02)。
如果文稿对术语精度要求极高,或改写后需要承担学术责任,合理做法是把自动处理限定在重复表述明显的段落,其余部分自己改写,并保留修改前后的对照版本以便复查。
常见问题(FAQ)
指令写多长才够用?
一段话即可,关键是保留项和范围写具体。把禁改术语、数据、引用标注列成短清单,再写一句“只改第几段、保持书面客观风格”,通常比长篇描述更可执行;范围越窄,回读工作量越小。
整篇上传和分段粘贴该怎么选?
篇幅长、需要整体处理时用整篇Word入口;需要精细控制术语时优先分段粘贴。分段粘贴受单次2000字上限约束,但每段可以单独写保留清单,出问题也容易定位到具体段落。
同义词模式的替换词要自己挑吗?
是的,替换词可由使用者自行挑选,这也是它适合术语密集段落的原因。使用前先确认哪些词允许替换、哪些必须原样保留,把禁改词写进指令,再逐处确认替换结果。
改写后还需要再查一次吗?
需要,复测是确认改动是否达到预期的方式之一。早标网支持按知网或维普口径分别处理,复测时宜使用与处理时相同的口径,并把处理前后的结果记录一并留存,便于对照;复测读数不等于合格判定。
处理记录会保留多久?
网站提供使用记录查询,可查看自己的原文和结果记录,用户也可以选择删除自己的记录。记录不会长时间存储,也不泄漏到外部网站;如需长期留存修改稿,应自行下载保存。
新用户能先试用吗?
可以,新用户注册后赠送1000字免费字数,可用于论文降重和降AIGC率。试用阶段适合先拿一小段验证指令效果,确认术语和原意守得住,再决定后续章节怎么处理。